FROM THE BOOKSHELF / A PAGE TO KEEP
V4 Pro 这一刀,把大模型的「不可能三角」砍穿了
发布于 2026-08-15
DeepSeek V4 Pro 0813 与 Grok 4.6 在 2026-08-12 同夜发布,让 1.5T 尺寸的中端模型第一次同时压住性能、价格、速度三角。本文用 5 项基准跃升、SemiAnalysis 海外背书、1100 万 token 跑腾讯财报的工程案例,拆解这条新的斩杀线,并给出明确的赢家/输家名单与三层行动建议。

V4 Pro 这一刀,把大模型的「不可能三角」砍穿了
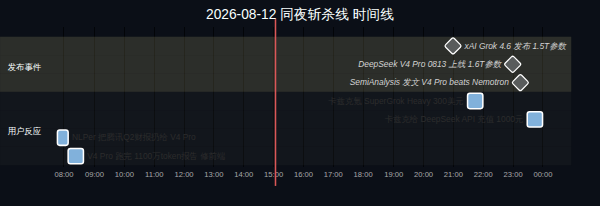
8 月 12 日晚 11 点,DeepSeek 把 V4 Pro 0813 正式版丢上了线。两个小时前,xAI 的 Grok 4.6 刚刚发布。两个 1.5T-1.6T 尺寸的模型,同一夜,把 Claude Fable 5 的体验区踩了一遍。
数字生命卡兹克当晚给 Grok 氪了 300 美元,又给 DeepSeek API 充了 1000 元。他不是为情怀买单,是给「主力模型」换岗。
这一夜发生的事,本质不是"价格战"。是 1.5T 这个参数段的中端模型,第一次同时把性能、价格、速度压到了同一个区间——这条没人命名过的边界线,被 V4 Pro 一刀砍穿了。
第一刀:DeepSWE 从 12.8 到 62.7,5 倍跃升
DeepSeek 自己放出来的基准对比里,最刺眼的不是单一指标的提升,是 9 项 Agent 基准里每一项都在涨,而且大多涨 30% 以上:
| 基准 | 4 月预览版 | 0813 正式版 | 提升幅度 |
|---|---|---|---|
| DeepSWE(软件工程) | 12.8 | 62.7 | 4.9 倍 |
| Cybergym(安全攻防) | 52.7 | 83.3 | +58% |
| AutomationBench | 12.8 | 31.8 | +148% |
| DSBench-Hard | 31.1 | 67.2 | +116% |
| Terminal Bench 2.1 | 72.1 | 87.9 | +22% |
5 个月前预览版还只能算"能跑通"的水平,今天正式版在 Terminal Bench 上 87.9 分已经超过 Opus 5 同类基准。这意味着 V4 Pro 不再是一个"够用"的模型,而是一个开始逼旗舰退位的模型。
(数据来源:DeepSeek 官方文档 + 值得关注的《DeepSeek,发动"临时价格战"》)
另一个值得说的细节是规格:1M tokens 上下文窗口 + 38.4 万 tokens 最大输出 + 默认开启思考模式。这意味着 V4 Pro 不仅"能做",还能"一次读完一整个中型代码仓库再开干"。对 Agent 工作流来说,这是从"分段喂"到"全量喂"的临界点。

第二刀:6 元/百万 tokens,不是终点是起点
V4 Pro 0813 的价格表:
- 输入(缓存未命中):3 元 / 百万 tokens
- 输出:6 元 / 百万 tokens
- 缓存命中输入:0.025 元 / 百万 tokens
把输出价格摆到国际坐标系里:Opus 5 的 1/30,Fable 5 的 1/60。一杯奶茶钱能买 500 万字生成,这不是夸张。
但更值得玩味的是 DeepSeek 自己在官方页面同步挂出的"涨价预告"——这意味着 6 元是引流价,不是常态价。苏扬把它定义为"临时价格战":先用 818 这种节点把价格砸穿同行心理防线,再用留住的用户把价格慢慢爬回来。
这是产品节奏,不是策略失误。DeepSeek 从一开始就打算让 6 元这个数字只活在宣传期——它真正想要的是:让"中等尺寸模型只能卖中端价"的行业默契失效。
第三刀:1.5T 打爆 3 倍参数模型
海外半导体分析机构 SemiAnalysis 在 X 平台发了一条很短的帖子:
"V4 Pro massively beats Nemotron 3 Ultra on agentic tasks."
Nemotron 3 Ultra 是英伟达 2026 年的旗舰开放模型,参数量是 V4 Flash 的近 2 倍、激活参数的 4.2 倍。但在 Terminal Bench 2.1 上,Nemotron 3 Ultra(NVFP4 量化版)得分 53.9——Flash 领先它 29 分,Pro 领先它 34 分。
4.2 倍的激活参数差距,被同尺寸模型用 Agent 能力反超了。
这件事的信号不在 Nemotron 本身——它的失败有 FP4 量化的因素——而在于:当 1.5T 这个尺寸已经能跨过旗舰线,"更大就是更强"的旧叙事第一次出现明显裂缝。

第四刀:腾讯财报的 1100 万 token 跑路
数字会撒谎,体感不会。
NLPer 在 8 月 12 日晚把腾讯 Q2 财报甩给了刚上线的 V4 Pro——一份包含港交所正式文件、电话会议记录的分析任务。V4 Pro 跑了大约 22 分钟,消耗 1100 万 token,落盘一份带业务拆分、风险提示和估值区间的 Markdown 报告。
接着让它"再写一个前端页面来展示这份报告"。模型自动加了图表、给财务摘要、业务板块、估值、风险各自配了视觉块。但马上暴露问题——一处文字渲染不对,股价图缺失。
它自己找到了原因。修了渲染逻辑,补上了股价图。
第二轮发现:长报告入口没放出来。让它加回去。新入口有了,Markdown 表格又错位。再修一次,能读了。
最后又调了一轮背景色和卡片层次,才把"一个做了很多图的 Demo"变成"一份能交出去的财报网页"。
整个过程几乎无人工干预。模型自己发现错误、自己定位、自己修、自己验证——这是 Agent 时代的典型工作流。
(来源:NLPer《DeepSeek V4 Pro 上线了,我把腾讯财报扔给了它......》)
第五刀:不可能三角为什么被同时压住
数字生命卡兹克在《一夜之间...》里点出了一个观察:
"大模型其实存在一个很难同时满足的不可能三角:性能、价格、速度。"
过去三年,这个三角的常态是:
- 性能:旗舰模型(Opus、Fable)才能压住,代价是价格
- 价格:开源 / 量化模型才能压住,代价是性能
- 速度:专线 + 小模型才能压住,代价是能力天花板
V4 Pro 第一次把这三个角同时拉到同一区间:
- 性能:DeepSWE 62.7、Terminal Bench 87.9,已经进入旗舰梯队
- 价格:6 元/百万 tokens 输出,比绝大多数中端定价还低
- 速度:1M 上下文 + 默认思考模式 + 500 并发限制,意味着它能接住中型 Agent 工作流的吞吐
三件事单独都不稀奇,稀奇的是同时发生。DeepSeek 用了三层组合:MoE 架构降低单 token 成本、推理引擎优化压首 token 延迟、产品分层(Flash 跑高频轻量任务、Pro 跑复杂推理任务)摊薄总持有成本。
这套组合不是哪个单一技术突破,是 1.5T 这个尺寸上的工程能力被推到了临界点。
谁赢谁输
这一刀砍下来,受益者和受伤者名单都很清晰。
赢家:
- 把异步 Agent 任务(财报分析、批量数据清洗、长报告生成)当日常的团队——V4 Pro 的 6 元价格让"先跑一遍再说"成为可行
- 个人开发者和中小团队——1M 上下文 + 默认思考模式,第一次让个人能调用"准旗舰能力"做产品原型
- 中国出海开发者——海外 API 价格的 1/30-1/60,意味着同样的预算可以做 30-60 倍体量的产品实验
输家:
- Sonnet、GPT-5.6 Sol 这种"中端定位"模型——它们的卖点是"比旗舰便宜 70%",V4 Pro 把便宜做到了 97%。这套定位逻辑失效了
- 仍在用"参数量大 = 强"做产品叙事的老一代国产模型——V4 Pro 用 1.5T 打爆 3 倍参数,已经把这条叙事从"信仰"变成"可证伪"
- 基础模型 API 转售商——当第一方 API 6 元/百万 tokens 时,加价转售的利润空间被压到极限
最大的输家其实是 "中等价位"这个赛道本身。V4 Pro 之后,中等价位要么往上调到和 Opus 一个区段,要么往下降到开源级。中间地带,越来越薄。
你现在该做什么
三条具体建议:
1. 把你所有"非实时反馈"的异步 Agent 任务切到 V4 Pro。 财报分析、长文生成、批量代码重构、文档翻译——这些任务 V4 Pro 已经能扛,6 元/百万 tokens 的成本意味着你不必为每个任务精打细算。
2. 把"贵 + 快"留给 Codex / ChatGPT,把"便宜 + 慢 + 准"留给 V4 Pro。 卡兹克那一晚的"主力模型换岗"做的就是这个分层:Codex 继续吃超大型不能出错的活,DeepSeek 吃量大但容错率高的活。
3. 不要立刻为 Grok 4.6 氪 300 美元。 Grok 4.6 的体验确实好,但订阅和按量是两个故事。先用 API 跑一周你的真实工作流,确认它在你的 Agent 工作流里能稳定接住哪一类任务,再决定要不要订阅。
最后留一个追问:DeepSeek 自己预告了 V4 Pro 涨价。如果涨到 18 元或 30 元——和 Opus 5 拉开 10-30 倍价格差的"基准线"会不会重新塌方?不可能三角会不会重新散开?
答案会决定接下来 3 个月国产模型的真正定价节奏。