Claude Code 砍了 80% 提示词,但 86% 的 Agent 项目还是死在"听我指挥"
Published on 2026-07-27
Anthropic 在 Claude Code 上删掉 80% 提示词,编码评测纹丝不动。同一周 EvoX 蜂群跑分追平 Codex。两个相反的故事指向同一真相:规则多寡从来不是信仰问题,是层级问题。
Claude Code 砍了 80% 提示词,但 86% 的 Agent 项目还是死在"听我指挥"
Anthropic 在自家旗舰 Coding Agent 上删掉了超过 80% 的系统提示词,编码评测纹丝不动。同一周,中国团队 EvoMap 用一套"蜂群式协作"的多 Agent 框架,在 6 个主流 benchmark、424 个任务上追平 OpenAI Codex。两个故事方向完全相反——一个拼命删规则,一个拼命加规则——却意外地指向了同一个真相。
真正的问题从来不是规则要不要,而是规则该塞在哪一层。
删 80%,删掉的是"过程教条"
2026 年 7 月 25 日,Claude Code 团队的工程师 Thariq 发了一篇长文,里面最炸的事实是:面向 Claude Opus 5 和 Claude Fable 5,他们删掉了 Claude Code 超过 80% 的系统提示词,Coding 评测没出现可测量的损失(来源:Thariq 推文 / Anthropic 官方博客)。
被删的提示词长这样:
In code: default to writing no comments. Never write multi-paragraph docstrings or multi-line comment blocks — one short line max.
换上去的是这一句:
Write code that reads like the surrounding code: match its comment density, naming, and idiom.
前一句是规则清单,规定注释写几行;后一句是判断依据,告诉模型拿什么当参照。规则消失了,约束其实更准了。 在一个注释本来就很密的老代码库里,"默认不写注释" 这条硬规则本身就是错的,而模型会认真执行一条错的指令。
<!-- 配图:六组 then-to-now 上下文工程变化 -->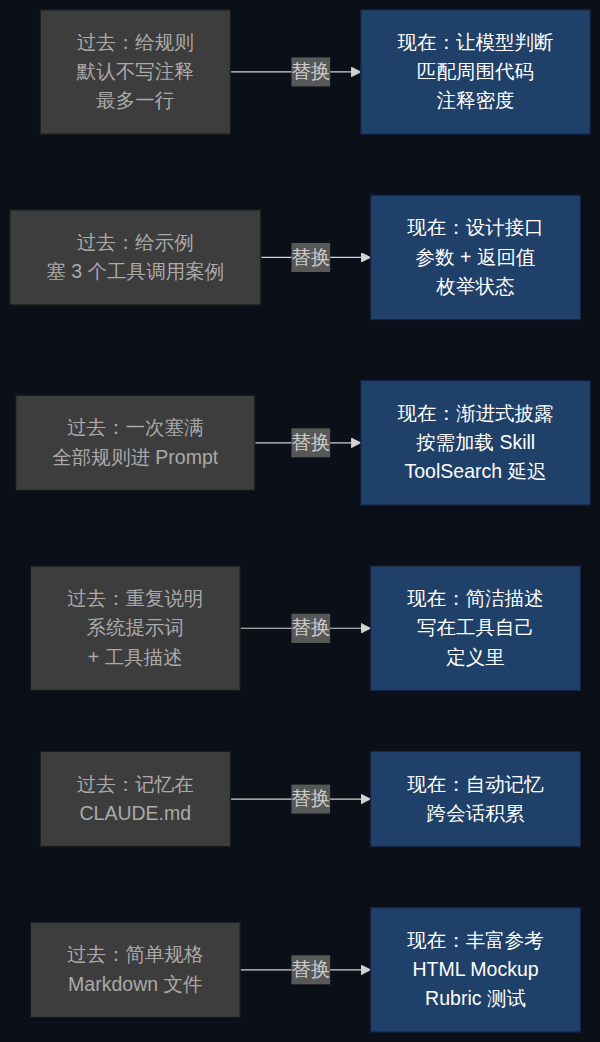
Thariq 把这种演化描述成"短—长—短"曲线。早期模型理解力差,需要短 Prompt 加大量示例和限制;模型能力起来后 Prompt 越写越长;到了 Opus 5、Fable 5 这一代,又短回去了。我们正好站在第二个拐点上(来源:Anthropic 长文)。
但很多人没注意 Cat 在那场访谈里讲的一句关键补充:只有最前沿那几个模型享受这次 80% 的削减,旧模型用的还是完整版(来源:花叔公众号)。
如果你跑的是 Sonnet、Haiku 或者更老的模型,照搬这套删法,大概率会变笨。
