FROM THE BOOKSHELF / A PAGE TO KEEP
「会不会被封」成了模型选型的第一指标
Published on 2026-08-11
美团把竞品的封号记录写进了自家技术文档。当谷歌和 Anthropic 相继收紧第三方调用,模型选型的第一指标正从跑分转向可用性。

「会不会被封」成了模型选型的第一指标
美团在自家技术博客里,记了一笔竞争对手的账。谷歌以「恶意使用」为由,大规模封禁通过 OpenClaw 路由 Gemini token 的账号;Anthropic 随后更新使用条款,禁止开发者通过第三方工具调用 Claude 的 OAuth token(来源:美团技术团队 tech.meituan.com/2026/03/09/LongCat-OpenClaw.html)。
这两句话写在一篇讲模型提速的文章开头。速度只是引子,美团在推销的是另一件事。他们卖的是「你的账号明天还在」。
封号记录被写进了对手的产品文档
厂商文案里出现竞品的封号细节,说明供应稳定性已经从运维话题变成了销售话题。
OpenClaw 在 GitHub 上拿到 23 万多 Stars(来源:美团技术团队博客)。这批用户里有相当一部分,把第三方订阅当成了长期基础设施来用——脚本挂在 CI 里,交付时间已经报给客户。谷歌和 Anthropic 的两次动作,把这些人的工作流一次性打回原形。
被封的人损失的不是那几十美元订阅费。是排期。
模型能力可以替换,工作流被中断的成本不能。
跑分这张牌,美团只打了一半
LongCat-2.0 的参数表摆出来是唬人的:总参数 1.6T,每个 token 激活约 48B,原生支持 1M 上下文,最大输出 128K(来源:美团龙猫团队发布,2026-06-30)。
按国内发布会的惯例,接下来该贴满 SOTA 柱状图了。美团没这么干。
第三方实测把差距写得很直白:IFEval、GPQA-diamond 这类通用能力和知识推理项目,LongCat-2.0 落后于 Gemini 3.1 Pro 与 GPT-5.5;换到 Terminal-Bench 2.1 和 SWE-bench Pro 这类编程任务,它基本追平 Gemini 3.1 Pro;FORTE 通用 Agent 任务上,与 Claude Opus 4.6 五五开(来源:AI 沃茨实测,2026-07-01)。
一个肯承认自己通用能力落后的团队,往往对自己的位置想得更清楚。LongCat-2.0 的战场在 Agent 任务,不在聊天窗口。
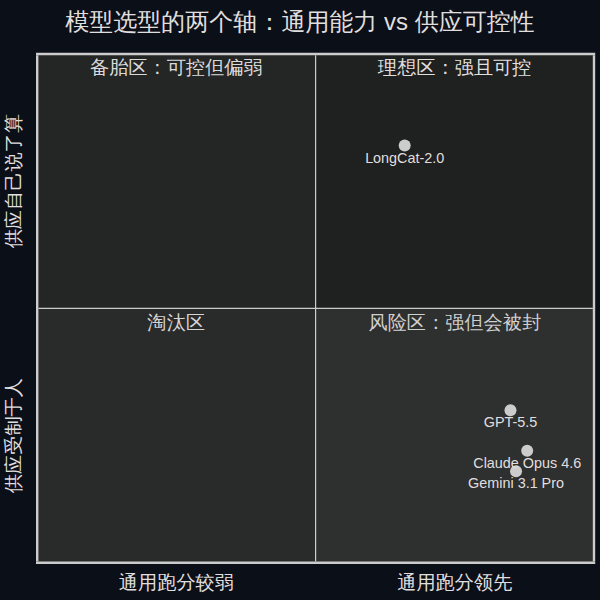
图里右下角那块,是今天多数团队的处境:手上的模型够强,但供应方随时能改规则。美团选择去左上角,用能力上的让步换供应上的确定性。
1M 上下文是为 Agent 铺的路
长上下文这个卖点已经被喊烂了,值钱的是它在 Agent 任务里怎么用。Agent 干活要读代码库、翻文档、记住前面十几步操作,还要继续调工具。上下文一旦装不下,模型就得靠检索和摘要打补丁,错误在多步任务里逐层累积。
LongCat-2.0 为此改了注意力机制。LSA(LongCat Sparse Attention)由 Streaming-aware Indexing、Cross-Layer Indexing 和 Hierarchical Indexing 三个组件构成,分别处理连续访存、跨层复用和由粗到细的候选筛选,目标是压掉长上下文里的 indexer 开销(来源:美团龙猫团队发布)。1M 上下文的价值,在于能把代码库、文档、日志和历史交互塞进同一轮任务。
后训练阶段的拆法也是冲着 Agent 去的:Agent Experts 负责工具调用、API 参数解析和自我纠错,Reasoning Experts 强化数学与多跳推理,Interaction Experts 管指令跟随和幻觉抑制,最后用 MOPD 把这些能力融合回一个模型(来源:同上)。
这套结构解释了为什么它在 Terminal-Bench 上追得上,在 GPQA-diamond 上追不上。能力是照着使用场景挑出来的,不是均匀长出来的。
分量在五万卡那一行
难复制的数字在训练日志里:五万卡国产算力集群,连续训练一个多月,吃掉超过 35 万亿 tokens,全程无回滚,没有一次不可恢复的 loss 突刺(来源:AI 沃茨实测,2026-07-01)。
这条链路不是一次冲刺跑出来的。龙猫团队从 2023 年开始摸国产算力,千卡规模起步,一路啃算子适配、通信优化和分布式稳定性,才走到五万卡上完成训练与推理(来源:美团龙猫团队发布)。三年时间,多数公司耗不起。
没做过大规模训练的人容易让「无回滚」这三个字滑过去。万亿参数 MoE 连跑一个月,中途一次救不回来的 loss 突刺,烧掉的是几百万的算力预算和两周工期。在英伟达生态里这已经够难,换到软件栈更薄、调试工具更少的国产 ASIC 上,难度再抬一档。
美团为这条链路补的工程细节相当具体:Embedding、FA、LSA、MoE 等模块换成自研确定性算子;Reduce 类算子改用分段二叉树累加,压低浮点误差累积,并在关键算子里加 bit-flip 检测;在 TP、CP、EP、DP、PP 之外引入 EMBP 来并行 N-gram Embedding;CP 扩展到 512 以上,支撑原生 1M 长度训练;流水线调度与显存优化合起来带来训练 MFU 约 1.5 倍提升(来源:美团龙猫团队发布)。
还有一处反常识的取舍。LongCat-2.0 的 MoE 稀疏率已经接近 97%,继续堆专家的边际收益很薄,团队把 135B 的参数预算挪去做 N-gram Embedding(来源:同上)。这是承认「堆专家」这条路快走到头了。
一条能重复跑通的训练链路,比一次漂亮的跑分更难伪造。
谁赢,谁输
赢的是做 harness 的那批人。LongCat API 同时兼容 OpenAI 格式与 Anthropic 格式,官方文档直接列出了 Claude Code、Kilo Code、OpenCode、OpenClaw、Codex 的接入方式(来源:美团龙猫团队发布)。接入成本被压到改一个 base_url 的程度。当切换供应商的代价接近于零,供应商的议价能力就跟着缩水。
美团给的效率数据是自测口径,打个折看:LongCat-Flash-Thinking-2601 在 OpenClaw 的 21 个可比非定时任务里,平均单任务耗时 2.35 分钟,比对比模型快约 30%(来源:美团技术团队博客)。数字本身不必当真,它透露的目标客户很清楚——跑自动化任务、按小时计成本的人。
输的是把单一订阅当基础设施的团队。你的模型再强,条款是别人写的,限流阈值是别人调的,封禁标准是别人解释的。
三件事,这周就能做

第一,把模型调用收进一层兼容层。业务代码不直接认某一家的 SDK,只认 OpenAI 或 Anthropic 格式的接口。这层薄薄的包装,是后面所有腾挪的前提。
第二,按场景分流,别指望一个模型全能。方案设计和界面相关的活交给通用能力更强的闭源模型;仓库级改写、长程任务、要塞进整个代码库的场景,交给上下文更长、供应更稳的那一个。
第三,把降级路径真的演练一次。写在文档里的备用方案不算数,得挑个周五下午,把主力模型的 key 停掉,看流水线多久恢复。
两年前这个行业焦虑的是:没有英伟达,还能不能接着做大模型。这个问题现在有了一份可复现的答案。往后一年要焦虑的换了一个——当主力供应商在凌晨改掉一条使用条款,你的流水线要多久才能爬起来。能力可以慢慢追,可用性得提前买保险。