FROM THE BOOKSHELF / A PAGE TO KEEP
当 AI 写的代码比人还多,最后一道门禁就不能只靠人了
发布于 2026-07-06
百度网盘 FE 团队的 AICR 多 Agent 协同审查方案:为什么单 AI 审查必然翻车,怎么用审查/核实/复核三 Agent 互相制衡,以及模型升级后规则为什么反而要软化。
百度网盘主端 FE 团队最近晒了一组数据:每月约 2000 次 CR(Code Review),其中 55.87% 的代码来自 AI。传统人工逐行审查的精度与专注度都在肉眼可见地下降,最后一道门禁效果锐减(来源:网盘 FE 团队 2026-07-06 发布的 AICR 准入实践长文)。
团队里一半以上的代码已经不再是人写的了,但负责把关的还是人。这个错位如果不解决,所谓"AI Coding 提效"就是把审 Bug 的成本转嫁给了 Reviewer,最后还是会以线上事故的形式还回来。
网盘 FE 团队给出的解法,是把 AI 嵌进 CI/CD 流水线做硬阻塞的质量门禁。他们给这套系统起了个名字:AICR。但看完他们 1.2 万字的复盘后我发现,值得借鉴的不是工具本身,而是他们从"单 AI 审查"踩坑走到"多 AI 制衡"的过程——这一路上的几个判断,每个在 AI Coding 渗透过半的团队都迟早会遇到。
<!-- 配图:多 Agent 协作审查流程图 -->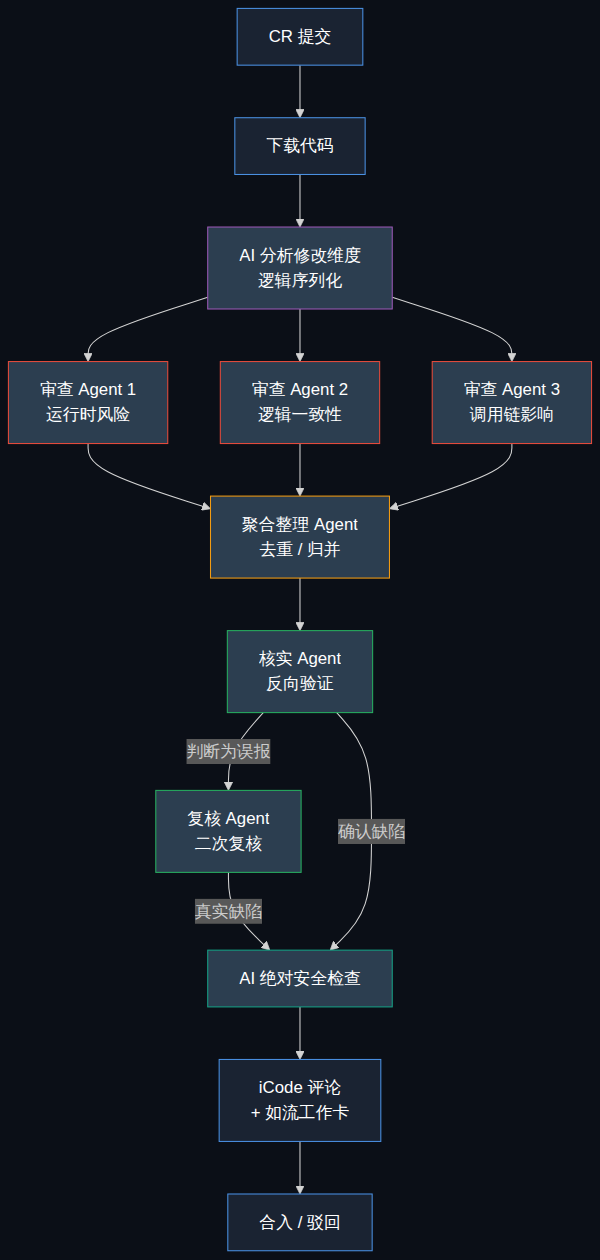
人工门禁正在失效,不是态度问题
把数字摊开看:2000 次 CR/月,AI 生成代码占 55.87%。Reviewer 每次要看的不只是代码风格,还要判断需求逻辑对不对、跨文件调用有没有同步、状态流是否完整、API 契约是否被破坏、运行时会不会崩溃。
CR 量级在放大,单次 CR 的修改规模也在放大。两端一起压,Reviewer 的注意力被稀释成几片——他们不是变懒了,是信息量超过了人脑的接收带宽。继续硬扛,结论只有一个:漏检。
所以问题不是"Reviewer 要更努力",而是要承认一个事实:当 AI 是主要代码生产者时,最后一道门禁必须也是 AI。问题是,AI 该怎么当这个门禁。
上一个"更聪明的 AI"远远不够
网盘 FE 团队最早用 GLM5.0 做检测,缺陷检出率只有 5% 左右。他们当时的思路是"既然模型不够强,那就用规则补"——把检测规则写得又细又硬,要求 AI 对修改调用链彻查、对代码逐行检验。
这个思路在弱模型阶段有效,规则确实能补足模型的检测深度。但后来他们把模型换成 GPT5.5,缺陷检出率飙升到 25% 左右——按理说该高兴,结果新问题立刻浮出来:审查耗时暴涨,输出内容膨胀到无法阅读,三路检测里有一半上下文是无效的。
他们复盘后得出一个反常识的心法:模型越强,规则反而要越轻。
强规则原本是给弱模型的拐杖,强行套在 GPT5.5 这种自带上下文检索和逻辑推理能力的模型上,反而成了束缚。模型被迫去做大量机械式彻查、生成大量无关联上下文,最后把后续审核 Agent 的注意力也带偏。
规则不是越多越好,而是要看模型能不能自己消化。 模型消化不了,规则就要硬;模型能消化,规则就要软。
<!-- 配图:GLM5 vs GPT5.5 A/B 对照数据 -->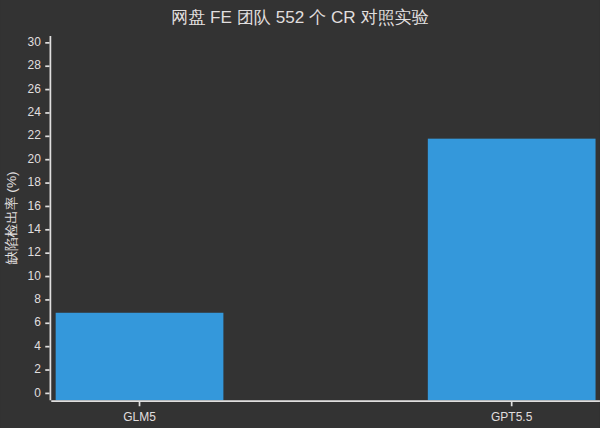
多 Agent 不是花活,是机制需要
把模型和规则都调对了,网盘 FE 团队又撞上一面新墙:单一 Agent 必然偏科。
他们做过一个对照实验:一周内 552 个 CR 用 GLM5 和 GPT5.5 分别审查——GPT5.5 检出 121 条(21.8%),GLM5 检出 38 条(6.9%)。GPT5.5 检出数量是 GLM5 的 3.2 倍,看起来 GPT5.5 是"更强"的审查员。
但"更强"不等于"更准"。他们发现 GPT5.5 有一个致命倾向:当模型被赋予"缺陷审查者"角色后,它会把这个角色的目标放大,把"找到缺陷"当成隐含奖励——倾向于从各种极端场景出发,把正常代码解释成异常风险。一句话总结:审查 Agent 容易放大风险,带来误报。
为了对冲,他们加了"核实 Agent",让模型反向验证问题是否真实存在。结果核实 Agent 也偏科了——它倾向于"为了核实问题而删除问题",把缺陷解释成正常逻辑,带来漏报。
这就是所谓的角色锚定偏差(Role Anchoring Bias):单一角色必然放大单一目标。审查 Agent 想多报,核实 Agent 想少报,谁都不是故意犯错,是角色本身的隐性奖励在牵引。
最终的解法不是找一个"不偏科的完美 Agent",而是承认没有完美的单个 Agent,只有互相制衡的多 Agent 体系:
- 并行审查 Agent(3 个不同方向):从运行时风险、逻辑一致性、调用链影响三个独立角度审查,扩大问题发现范围
- 聚合整理 Agent:把三路结果去重、归并、整合
- 核实 Agent:反向验证问题是否真实存在,过滤明显误报
- 复核 Agent:当核实 Agent 删除某个问题时,二次复核避免真实缺陷被误删
四个 Agent 形成"审查 → 聚合 → 核实 → 复核"的链条,让模型之间互相补位、互相制衡。审查 Agent 想多报?由核实 Agent 压一压。核实 Agent 想漏报?由复核 Agent 兜回来。
这种"多岗交叉"的思路,和机场安检一个逻辑——主检员必然有倾向,那就再配一个复核员;复核员也偏,那就再配一个监督员。完美的安检员不存在,完美的安检流程存在。
5 分钟甜点时间,逼出来的工程取舍
多 Agent 听起来漂亮,但有一个硬约束:审查不能慢。
网盘 FE 团队把审查甜点定义为平均 5 分钟。原因很现实——超过 5 分钟,开发者的耐心窗口就破了,CR 流程会堵,提测会延期,最后整个团队会选择绕过这个门禁。
5 分钟要把 4 个 Agent 全跑完,每个 Agent 的时间预算必须卡死。最终他们把审查链路拆成 7 个阶段:
- 下载代码
- AI 分析修改维度(逻辑序列化)
- AI 代码缺陷审查(三路并行)
- AI 缺陷核实
- AI 缺陷复核
- AI 绝对安全检查
- AI 生成建议与评论
每个阶段都有独立超时策略和输出边界,避免单个 Agent 过度推理、反复发散、长时间等待。
这套设计背后的工程取舍是:检测质量和耗时永远在拉扯,牺牲质量换速度,或者牺牲速度换质量,都不是解。解法是把流水线分段,让每个阶段自己控制质量与时间的平衡点。
顺便说一句:他们还专门对比了 CI/CD 流水线 vs 本地 Pre-commit 两条路,最终选 CI/CD。原因是 CI/CD 能在团队级别统一规则、统一执行环境、统一数据沉淀,能把审查结果回写到 CR 评论、智能工作卡里形成完整链路;本地 Pre-commit 只能服务提交者本人,对正式 CR 流程的辅助价值有限。这条选择对所有想搞 AI 审查的团队都有参考意义——本地工具适合个人自检,团队准入必须走流水线。
拿走就能用的三条判断
AICR 不是开箱即用的产品,网盘 FE 团队的代码也未必能直接复刻。但他们踩坑踩出来的判断,每个在 AI Coding 渗透过半的团队都迟早要回答:
判断一:你的 AI 审查是不是单 Agent? 如果是,半年内一定会撞上角色锚定偏差——审查 Agent 多报、核实 Agent 少报。准备多 Agent 体系,至少要有"审查 + 复核"两个独立角色互相制衡。
判断二:你的规则强度匹配你的模型能力吗? 模型弱(GLM5 5% 检出)需要强规则补;模型强(GPT5.5 21.8% 检出)需要规则软化。用一个固定的规则模板套所有模型,必然在某个阶段出现"模型越强,审查越慢、噪音越多"的怪现象。
判断三:你的审查耗时有没有卡死? 5 分钟是个不错的起点。把流水线分成多个阶段,每个阶段独立超时、独立控质量。没有时间预算的 AI 审查,最终都会被业务侧绕过。
AI Coding 不会停。当团队里 50% 以上的代码都是 AI 写的,最后一道门禁就不能再押在"人盯代码"上了。把门禁交给 AI,又不能让 AI 自己说了算——让人 + 多 AI 互相制衡,才是这道门禁的形态。
参考:百度网盘主端 FE 团队《AI 写代码越来越快,质量谁来守?网盘主端 FE 的 AICR 准入实践》(2026-07-06)、得物技术《基于 Cursor Agent 的流水线 AI CR 实践》(2026-03)、阿里技术《给"氛围编程"系上安全带:阿里集团 AI 代码评审实践与 Benchmark 开源》(2026-03-12)