FROM THE BOOKSHELF / A PAGE TO KEEP
Scaling Law 第一页就写错了:一个 bug 烧掉五年算力,我们还在用最浪费的语言制定 AGI 路线图
发布于 2026-07-06
OpenAI 2020 论文 bug 烧掉五年算力:DeepMind 研究员 Diogo Almeida 揭秘「三步骗术」,Chinchilla 自己也带 bug,Scaling Law 是用最浪费算力的英语跑出来的。

2026-07-04 深夜,OpenAI 前研究员 Diogo Almeida 发博客指认 2020 论文 bug,DeepMind Sander Dieleman 推文背书。OpenAI 用「固定 token + 余弦 LR 衰减 + 权威背书」三步制造了「模型已经饱和」的假象。Chinchilla 想纠正,发现自己也有 bug。最要命的是——这条曲线,是用最浪费算力的英语跑出来的。
不是我们理解错了 Scaling Law。是 Scaling Law 自己错了。
2026 年 7 月 4 日深夜,前 OpenAI 研究员 Diogo Almeida(现 DeepMind)发了篇博客,标题冷得发指——《Scaling Laws, Honestly》。
开头一句直接把话撂这:最初那版 scaling law 是错的,因为存在一个 bug。
DeepMind 的 Sander Dieleman 转头就在推上把它顶了上去,补了一刀:「大概率害得业界在一堆『体量过大、训练不足』的模型上,白白烧掉了海量算力。」
一个 bug,烧掉五年。
但这事比你想的更荒诞——连那个纠正 bug 的论文,自己也不干净。而且,我们一直在用最浪费算力的语言,制定全人类通往 AGI 的路线图。

三步骗了全球同行
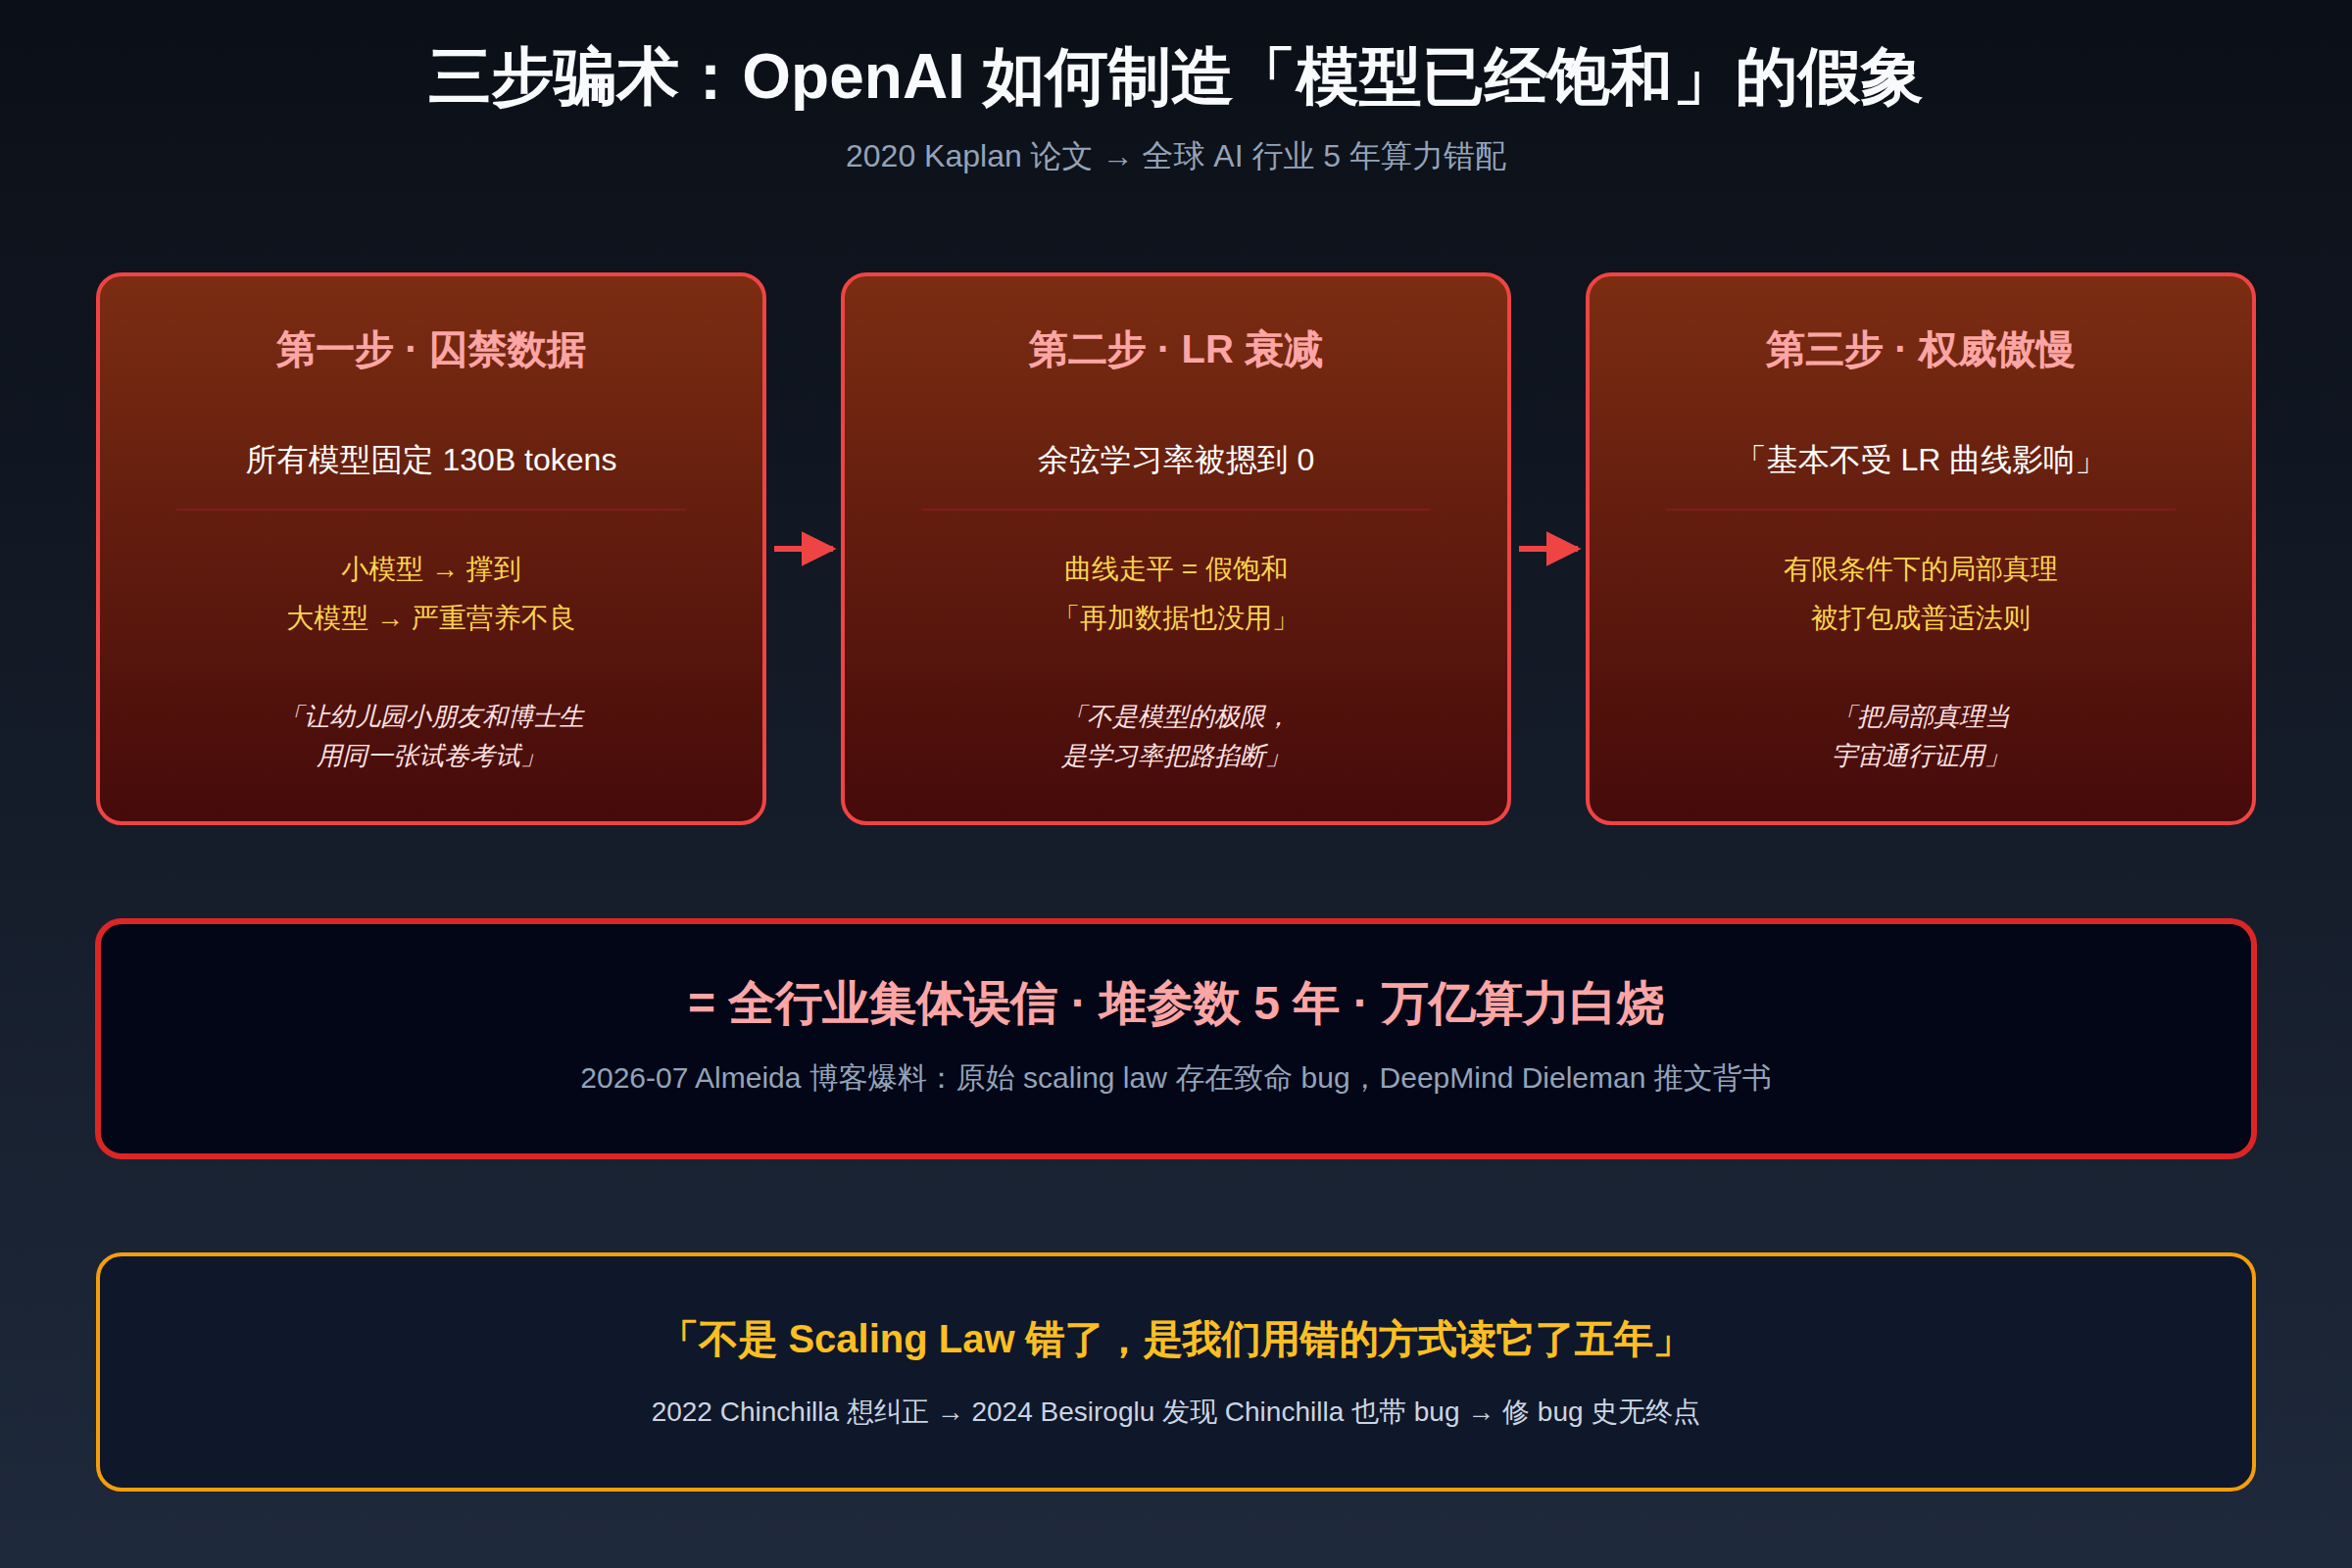
OpenAI 2020 年那篇 Kaplan 论文,用三步制造了「模型已经饱和」的完美假象。
第一步:囚禁数据。
所有模型——不管你是幼儿园小朋友还是博士生——喂完全相同的饭量:大约 130B tokens。小模型被撑到,大模型严重营养不良。Chinchilla 论文后来一针见血:「对所有模型使用了固定的训练 Token 数和学习率调度方案。」
这就像让所有人用同一张试卷、同一时间考试,然后宣布成绩只跟天赋有关。你测不出谁是真正的上限,因为考试时间根本不够他把题读完。
第二步:掩耳盗铃的 LR 衰减。
余弦学习率衰减,这帮人在训练快到预设终点时,把学习率人为摁到零。曲线一走平,看上去模型学到头了,再喂也没用。
这不是模型的极限。这是学习率把成长之路掐断了。
但那条曲线看起来太像「精心设定」的了。连当年在 OpenAI 做优化的 Diogo 自己都承认,他没看出这个 bug。谁会怀疑一条平滑衰减的曲线?
第三步:权威的傲慢。
论文里写了句「结果基本不受学习率曲线影响」。在固定 token 的约束下,这句话技术上能自圆其说。但它被当成了普适法则。他们把有限条件下的局部真理,打包成宇宙通行证。
三步叠在一起,你得到一条既错、又极难 debug 的定律。全行业拿着这张错地图,在「堆参数」的跑道上狂奔了五年。
纠正 bug 的论文,自己带着另一个 bug
2022 年,DeepMind 用 Chinchilla 把结论翻了过来。
700 亿参数,喂 1.4 万亿 token。体量不到 GPT-3 的一半,数据是它四倍多。结果全面反超 2800 亿参数、只喂了 3000 亿 token 的 Gopher。
结论被改写:参数和数据应该几乎同等重要地放大,比例约 1:20。翻译成人话——同样一笔钱,OpenAI 养了个虚胖的壮汉,DeepMind 练出个精瘦的拳手。
你是不是觉得这事终于翻篇了?
2024 年,Besiroglu 那帮人把 Chinchilla 原文数据点扒出来重跑。发现 Chinchilla 自己的拟合也藏着 bug:优化器的 loss 尺度设得过高,Huber 损失按样本求了平均而不是求和,导致拟合过早终止。
纠正 bug 的论文,自己带着另一个 bug。
翁荔 2026 年 6 月发了篇长文《Scaling Laws, Carefully》,从头梳理这条线。她扔了句特别冷静的话:Scaling Law 不是牛顿三定律,只是经验拟合的曲线。外推到「数据无限」领域,必须谨慎。
但我想说的不是这个。

我们一直在用猪的胃口,制定全宇宙的营养标准
这事最荒诞的部分甚至不在 bug 本身。
研究者 Adam Zachary Wasserman 做了个反直觉的实验:同样架构、同样算力训练模型。法语模型达到同等语法能力的效率,比英语模型高出 50 到 100 倍(待核实)。
为什么?英语是「形态贫乏」语言。词汇本身不带太多信息,模型得靠海量数据硬猜词义。法语、中文这些形态丰富的语言,词汇本身就携带大量明确信号。
这意味着什么?
我们现在所有算力配比方案,都是基于最「吃数据」、最低效的一种语言制定的。
你以为你在探索通用智能的物理定律。你其实只是在测量英语这门语言有多浪费算力。
这就像你想通过研究一头猪的胃口来制定全宇宙生物的营养标准。猪胃口大,不代表老虎也该吃那么多。更不代表计算猪食消耗的电费,就能推演猎豹的奔跑效率。
所以呢
Diogo 揭开的这个 bug,不只是学术史上的脚注。
它意味着 GPT-3 那一代模型,可能全都是「体量过大、训练不足」的虚胖产物。堆参数堆出来的能力,跟喂足够数据能激发的能力,不是一回事。
它意味着 Chinchilla 那条「1:20」的黄金比例,可能还得再修正一次。
最要命的是,我们在错误的算力配比上,烧掉了五年和天量的显卡钱。
而且——这条 Scaling Law 是用英语跑的。如果换中文、换法语、换任何一门形态更密集的语言来重新测量,整条曲线会不会长成另一个样子?
我不确定。
但有一件事我很确定:当你看到 OpenAI 下一个千亿美金训练集群的预算时,记住这篇 2020 年的论文。它第一页的实验设计就写错了。
而这条错的曲线,至今躺在无数投资人的尽调材料里。
参考来源:
- Diogo Almeida, Scaling Laws, Honestly (2026-07-04), completeskeptic.com
- Sander Dieleman 推文背书 (2026-07-04)
- Lilian Weng, Scaling Laws, Carefully (2026-06-24), lilianweng.github.io
- Besiroglu et al., 2024 论文
- Adam Zachary Wasserman 语言效率实验(待学术会议公开)
- ASI 启示录 / 新智元 / 量子位 中文 AI 媒体复盘 (2026-07-05)