FROM THE BOOKSHELF / A PAGE TO KEEP
当 Claude Code 成了"竞品原料"——Meta 限令揭开 AI Coding 工具的真实身份
发布于 2026-07-06
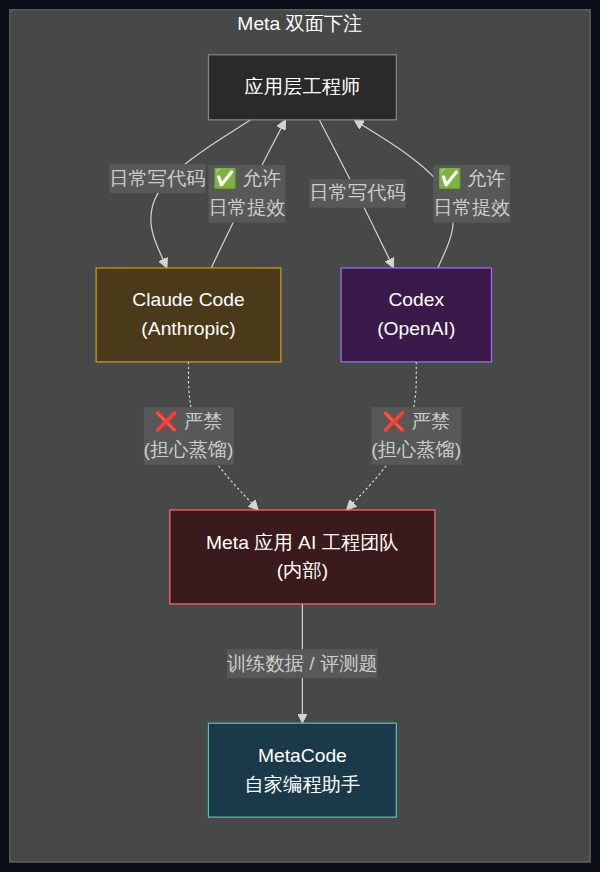
The Information 6 月底披露了一份 Meta 内部备忘录:应用 AI 工程团队的工程师被限制使用 Claude Code 和 Codex,原因是"担心无意识蒸馏竞争对手"。Meta 一边是 Anthropic 的最大客户之一,一边要自研编程助手 MetaCode,**它正卡在 AI Coding 时代最尴尬的位置**。

The Information 6 月底披露了一份 Meta 内部备忘录:应用 AI 工程团队的工程师被限制使用 Claude Code 和 Codex,原因是"担心无意识蒸馏竞争对手"。Meta 一边是 Anthropic 的最大客户之一,一边要自研编程助手 MetaCode,它正卡在 AI Coding 时代最尴尬的位置。
这件事远不止一次内部合规调整。它说明 AI 编程工具正在悄悄换身份——从"开发者的辅助软件"升级为"模型研发供应链的上游环节"。Meta 画的这条线,几乎是全行业迟早要画的那条线。
不是合规问题,是产业结构问题
先说蒸馏是什么:基于一个模型的输出,去训练或改进另一个模型。OpenAI、Anthropic、Google 的服务条款里都写着"不许用我输出造竞品"。这些条款在 2023 年之前几乎没人当真——大模型公司互相爬数据、互相蒸馏,是行业默认的灰色地带。
2024 年,Anthropic 直接切断了 OpenAI 的 Claude API 访问。理由是 OpenAI 拿它来评估自家模型,"不符合行业标准"。这是头部公司第一次把"蒸馏"从潜规则拉到明面上。Anthropic 的判断很清楚:评估自家模型这件事,OpenAI 应该用人类写测试题,或者用开源模型,不应该直接调用商业竞品的 API。
今年 4 月,第二个转折点出现。马斯克在和 OpenAI 的诉讼里被迫承认:他旗下 SpaceX 的 xAI"部分"蒸馏过 OpenAI 的模型。蒸馏从潜规则变成法庭议题。
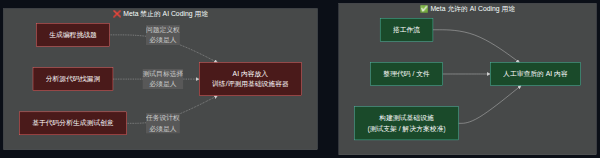
Meta 这份 5 月起草、6 月生效的限令,是第三个转折点——巨头之间第一次把"我们不能让 AI Coding 工具的输出进入自家模型链路"写成正式条款。注意 Meta 管的不是工程师写代码——Meta 依然允许用 Claude Code 搭工作流、整理文件、构建测试基础设施。它真正管的是三件事:编程挑战题怎么出、bug 怎么定位、测试容器里放什么。
这三件事,恰好是模型研发的核心资产。
三个不能碰的边界
把 Meta 的内部指南拆开,能看到一条非常清晰的隔离线。
第一,编程挑战题不能由模型出。 Meta 应用 AI 工程团队的核心任务是改进 MetaCode——构建高质量数据集、设计编程挑战、训练和测试代码模型。指南明确说:"我们不希望任务来源于模型。""这明确属于工程师不再掌控局面的情况。"(The Information 引述内部文件)
工程师的判断、领域知识、设计意图,是模型学习的目标函数。一旦这些函数本身由另一个模型生成,自家模型的能力归属就说不清楚了。
第二,bug 分析不能由模型主导。 指南禁止工程师用 AI 查找源代码漏洞,或基于代码分析生成测试任务创意。换句话说,AI 可以帮你写补丁,但不能帮你决定应该测什么。问题定义权是人类的,模型执行权可以是 AI 的——Meta 在划这条线。
第三,测试容器里不能放 AI 生成材料。 Meta 的指南还有一条很技术细节:如果被测的内部模型能访问某些基础设施容器(包含代码、库、运行环境的隔离环境),那么任何 AI 生成内容都不能被放进这些容器。担心的是第三方模型的输出如果被内部模型接触到,后续可能间接进入训练链路。
容器隔离这道闸门,是 Meta 把"竞品原料"挡在自家供应链外的最后一道物理防线。
数十亿美元的内部账单
限令背后还有一个不太被讨论的变量:钱。
根据 The Information 看到的内部备忘录,Meta 2026 年仅内部 AI 使用支出就将达到数十亿美元。在推动全员采用 AI 之后,公司已经开始限制员工的 token 用量。把更多开发工作迁移到 MetaCode(前身 DevMate)上,"变得越来越重要"。
这就形成了一种微妙的矛盾:Meta 既要外部 AI 工具的研发效率,又要避免这些工具的贡献污染自家模型。它需要的是 AI Coding 的"提效红利",但必须把"模型能力红利"从外部工具身上剥干净。
马斯克的 xAI 也是同一个剧本——一边用 OpenAI 模型蒸馏,一边自研 Grok。Meta 这回相当于把剧本里的潜规则写成正式条款。

每个公司都会撞上这堵墙
Meta 不是特例。所有既要买外部 AI Coding、又要自研编程模型的公司,都会撞上同一堵墙。
国内的几家头部也跑不掉。豆包编程助手、Kimi 的代码能力、DeepSeek-Coder、智谱 GLM-Coder——任何一家要继续做自己的代码模型,迟早要回答同一个问题:当工程师用 Claude Code 或 Copilot 写出 1000 行代码、再用自家模型去理解、模仿、超越这些代码时,自家模型的能力到底来自谁?
Anthropic 的服务条款已经写得很直白:禁止使用模型输出构建竞争性系统。OpenAI、Google 的条款类似。当 Claude Code 在字节跳动内部被使用、它的输出又进入了字节自研模型的训练数据——这就是 Meta 现在担忧的同一件事,只是还没被写成内部备忘录而已。
更隐蔽的一层是评估污染。Meta 指南专门提了一条:如果团队用 AI 生成或编辑评估任务,就会"无法明确判断是人类还是模型应对此负责"。MetaCode 的能力评测如果被 Claude Code 的输出污染,评测出来的"进步"到底是 MetaCode 的,还是 Claude Code 的影子?
这是 Meta 限令最深的一层意思——它不只担心训练数据被污染,它担心的是连"证明自家模型有多强"这件事都被污染。当所有头部模型在 HumanEval 这类公开 benchmark 上分数越来越接近,评估方法本身的"纯度"就成了新的差异化点。Meta 这次画线,落在实处,就是在保护自家评测体系的可信度。
这条线迟早要画
开发者侧的故事是:AI Coding 工具让你一周省 4 小时、10 小时、20 小时。
模型公司侧的故事完全相反:AI Coding 工具的每一行输出,都是潜在的竞品原料,必须严格隔离到特定场景之外。
Meta 这份限令,是第一个把这层意思写成正式公司条款的案例。它管的核心问题是:AI 工具在研发链路里能走到哪一步。允许的范围比很多人想象的窄——写代码可以,出题不行;分析 bug 可以,决定测什么不行;放进一般工作流可以,放进训练容器不行。
这条线一旦画出来,竞争对手就有压力跟进。Anthropic、OpenAI、Google 会更严格执行自家服务条款里的"不得用于竞品研发"条款。Meta 的限令会成为模板——以后任何一家"既用 Claude Code 又自研编程模型"的公司,都要拿出类似的内部合规文档,否则就是给合作方递把柄。
AI Coding 工具的真实身份,正在从"开发者的瑞士军刀"悄悄切换成"模型公司的上游供应链"。Meta 是第一个被架在火上烤的,但不会是最后一个。
赌一个判断:未来 12 个月内,至少三家头部大厂会公布类似的内部限制令。 不是因为 Anthropic 或 OpenAI 投诉,而是因为他们必须自证——自家模型的能力,真的不是从对手的工具里蒸馏出来的。
这条证据链,从今天开始变得比模型 benchmark 更重要。