FROM THE BOOKSHELF / A PAGE TO KEEP
DeepSeek 给 Flash 装上眼睛——多模态 Agent 不再是 Plus 的特权
发布于 2026-08-22
DeepSeek 把多模态视觉做到 Flash 级别、定价不变,多模态 Agent 价格战的关键节点。
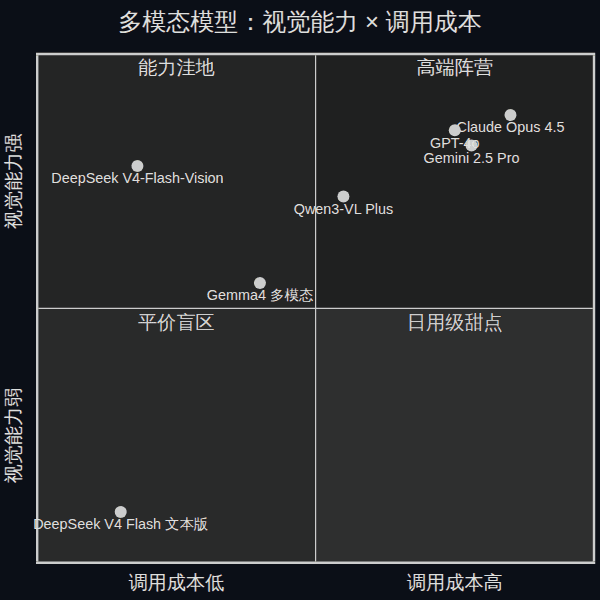
2026 年 8 月 21 日,DeepSeek 把多模态视觉塞进了 Flash。这件事比它表面看上去重要得多。
DeepSeek 这次发布的不是 V4-Pro、不是 V4-Plus,是 deepseek-v4-flash-vision-exp——Flash 系列。这是 DeepSeek 第一个对外开放的多模态视觉理解模型,定价与 V4-Flash 完全一致,单图最多 384 token,并发上限 2500(来源:DeepSeek API 官方文档 https://api-docs.deepseek.com/guides/vision)。
在多模态这条赛道上,最不缺的就是"又一个模型发布了"的新闻。DeepSeek 这次值得记一笔的理由不是它有多强,而是它把多模态做成了 Flash 级别的平价日用品。
为什么是 Flash,不是 Plus
过去一年,多模态视觉模型的主战场是 Plus、Pro、Opus 这类旗舰型号。DeepSeek 反过来选了 Flash,原因不复杂:多模态 Agent 真正的门槛从来不是能力,是成本。
Flash 在 DeepSeek 产品线里一直是价格屠夫的角色——V4-Flash 文本版已经把每千 token 的价格压到了几乎能让 Agent 跑全天候工作流的位置。在这个基础上加视觉,等于在已有的便宜地基上直接盖房。
具体的成本设计有两个关键点:
- 单图按尺寸计费,最多 384 token。你传一张 4K 截图和一张缩略图,开销差别不大。这等于从模型层面挡住了"参数通胀"——视觉模型最大的隐性成本失控点是用户上传越来越高分辨率的图,DeepSeek 用 token 上限把这件事提前封死。
- 高峰/空闲两档价与 V4-Flash 一致。并发 2500 没变。这意味着现有跑 V4-Flash 的 Agent 工作流,换成视觉版几乎不用重新算账。
让 Flash 看见图,比让 Plus 看见图,对整个行业的影响大 10 倍。
技术细节:这次升级了什么
开发者关心的不是发布会上的 demo,是接进来要改几行代码。这次更新的几个点都打在痛处上。
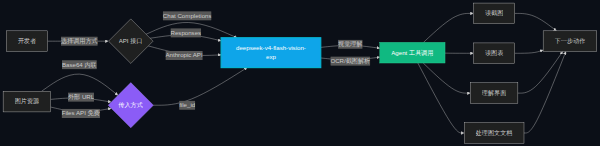
接口兼容性拉满。模型支持 Chat Completions、Responses(OpenAI 格式)和 Anthropic API 三种调用方式,三种图片传入方式——Base64 内联、外部 URL、Files API。Files API 是这次同步上线的关键新东西,且免费。
Files API 解决的痛点很具体:以前每发一次请求都要把图片重新编码塞进 body。视觉 Agent 跑批量截图分析时,这个带宽浪费能把账单堆出尖峰。现在上传一次拿到 file_id,后续请求直接引用,逻辑和 Git LFS 引用大文件一个意思。
容量天花板直接拉到生产可用级别。单次请求最多 600 张图片,最长边 8192 像素。Base64/URL 单图最大 32 MiB;Files API 单图最大 64 MiB;含 file_id 单次请求图片总量上限 200 MiB。细节等级提供三档:low(512×512 缩放,省 token)、original(保留原图)、auto。
性能方面,官方给出的对照结果是:纯文本任务(推理、世界知识、工具调用)与 V4-Flash 持平;视觉 Agent Benchmark 上大幅跃升,多模态 Agent 能力接近 Claude Opus 4.8(来源:DeepSeek API 官方更新 https://api-docs.deepseek.com/updates/)。
为什么这件事不只是"DeepSeek 发了个新模型"
把视角拉远一点看,整个 2026 年上半年的多模态赛道,价格一直是主战场。Qwen3.5、Gemma4、GLM-5.3 在多模态上卷了一年,但绝大多数"能力跃迁"都伴随着 Plus 级的定价。DeepSeek 这次的反常是:能力追到了旗舰 90% 的位置,价格还停在 Flash 上。
更关键的是一个细节被多数报道忽略——之前的 V4-Flash 文本版,在 ApexBench 和 Agents' Last Exam 这类基准上,会直接忽略题目里包含的多模态元素(来源:CSDN 公众号报道引用官方说明)。这意味着过去一年卡死 Agent "看截图→调工具"链路的根因,是文本模型本身看不见图。
视觉能力补齐之后,这条链路第一次在 Flash 级别跑通了。这是 DeepSeek 把多模态做进 Flash 而非 Plus 的真正理由:Agent 的工程现实需要日用品级别的视觉模型。
三个没被讲清楚的事
泼盆冷水。V4-Flash-Vision-Exp 名字后面挂的是 Exp,官方自己也没打包票。
第一,第三方独立基准测试缺位。"接近 Opus 4.8"目前来自官方自评,Datawhale 在报道中明确写道:"该比较尚未出现在 DeepSeek 当前的官方模型文档中,仍需等待更完整的技术说明与第三方测试。"
第二,完整技术报告未发布。为什么是 Flash 级别能做到这个能力?视觉编码器是什么架构?训练数据怎么配比?这些都得等。
第三,视觉幻觉与截图注入攻击的风险。模型现在看得见截图,就意味着攻击者可以通过截图注入恶意指令。V4-Flash-Vision 的 prompt injection 防护机制官方没有表态,这是多模态 Agent 的一个全新攻击面。
结尾:这场仗怎么打
2026 年下半年,多模态 Agent 的胜负手不在分数上,而在价格 × 兼容性这个矩阵里。
DeepSeek 用 Flash 给全行业上了一课:别再把多模态做成 Plus 专属功能。旗舰模型是给研究者和重度用户准备的;日用级 Agent 需要的是平价 + 兼容 + 生产可用的视觉能力。三件事里只要少一件,多模态 Agent 就不可能成为水电煤一样的基础设施。
给开发者的行动建议只有一条:现在就把它接到 DeepSeek Harness 里跑。先做一件事——把你现在用 OCR + 文本模型两段拼接的截图解析工作流,换成单次调用 V4-Flash-Vision。比一比延迟、token、稳定性。三件事里如果有两件打平,这事就值得换。
剩下的,等 Exp 摘掉再说。