GLM-5.3 击败 GPT-5.6-Sol 的那天,国产 Coding Agent 才真正能交付
发布于 2026-08-15
用 Datawhale 在 8 月 15 日做的同题实测切片,论证国产开源模型(GLM-5.3)+ 国产 Agent 运行时(DeepSeek Harness)首次在生产级任务里,工程细节反超 GPT-5.6-Sol。这是一个被官方宣传词掩盖的工程拐点。

GLM-5.3 击败 GPT-5.6-Sol 的那天,国产 Coding Agent 才真正能交付
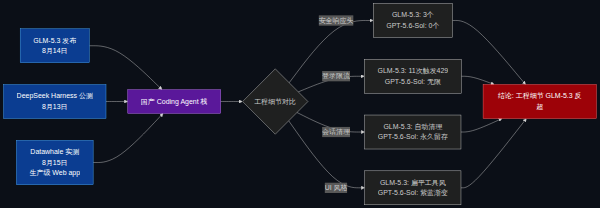
8 月 13 日 DeepSeek Harness 公测。8 月 14 日智谱甩出 GLM-5.3,Z.ai Code Bench 编程能力暴涨 50%,顺手在国内外项目里挖出 2404 个漏洞。8 月 15 日,Datawhale 拿这套组合跟 GPT-5.6-Sol 跑同一道生产级抠图 Web app——核心功能打平,工程细节反超。
官方通稿铺天盖地讲"50%"和"2404"。这俩数字我不会否认真实性,但我要说句难听的:榜单分数和漏洞猎杀,都不是这场发布真正值得你关心的东西。
真正的大事是:国产开源模型第一次在生产级任务里,工程交付能力超过了 GPT-5.6-Sol。这事发生在 8 月 15 日,之前从没发生过。
同基座榨出 50%,后训练干的事比你想的脏
GLM-5.3 没有换基座,没有扩参数,没有重新预训练。智谱的工程师只是在 GLM-5.2 的基座上做后训练,就把编程能力拉高了 50 个点。
这意味着什么?基座里的能力本来就在那里,只是没被激发。 后训练不是灌输新知识,是把模型已经在潜伏的东西逼出来。像给一个会弹琴但没上过台的人做突击排练,台上突然稳了。
智谱联合国内安全团队做的白盒审查也值得提。发布前两周,GLM-5.3 在国内外项目里定位出 2404 个潜在漏洞,1088 个中高危。最早的风险可以追溯到 40 多年前——DNS 协议、邮件传输、操作系统底层的陈年旧账。
这不是"AI 抓 bug"的玩具 demo。一个有 40 年跨度的代码库安全检查,即使对人类专家来说也是地狱级任务。GLM-5.3 做这件事的方式,是深入到协议实现和内存管理层面,不是给代码拍 X 光片,是在翻一座旧宅的承重墙。
但注意,漏洞发现能力跟"工程交付能力"是两码事。能找出 40 年前的 bug,不代表能写出 40 年后还能维护的代码。 前者是诊断,后者是建造。真正的考验在三天后的 Datawhale 实测里。
没有 Harness,GLM-5.3 只是一块好芯片
如果你用 Codex 类产品的思路看 DeepSeek Harness,你会完全搞错重点。它不是一个"DeepSeek 牌 VS Code",也不是国产 Claude Code。
DSH 是一个 Agent 运行时。 给它换个类比的话,它是 Agent 世界的 Linux 内核,不是又一个发行版。
Everything is a plugin——模型适配器是插件,策略是插件,提示词模板是插件,存储方案是插件,UI 是插件,上下文压缩策略也是插件。你拿一组插件拼出一个属于自己的 Coding Agent,跟拿 syscall 组装出一个操作系统变体一样自由。

公测几天内 300 个插件冒出来。注意,这不是 VS Code 插件市场那种"给你的编辑器加个主题包"。DSH 的插件切到 Agent 的大脑、工具箱、规则引擎、交互界面——是神经外科手术刀,不是贴纸。
对 GLM-5.3 来说,Harness 的价值很具体:它把模型从"能写好代码"推到"能交付可上线的活"。 光有模型,你只能在聊天框里让它生成一个抠图函数。接进 Harness,你让它跑通一个完整的 Web 应用——账号体系、异常处理、部署文档、安全响应头,全都有地方落地。
Datawhale 做的就是这件事。他们把 GLM-5.3 接进 DeepSeek Harness,跟 GPT-5.6-Sol 跑同一道题。GPT-5.6-Sol 用的什么环境?大概率是 OpenAI 自家最顺手的那个。你猜结果怎么着。
三道工程细节题,GPT-5.6-Sol 交了白卷
题目是九个字码农都熟悉的活:生产级抠图 Web 应用。九条验收:可运行、账号体系、异常处理、可部署交付、项目文档……每一条单独拿出来都不难,加在一起就是真实项目的样子。
第一题:安全响应头。
GLM-5.3 的版本,每个 HTTP 响应都默认带三个安全头:X-Content-Type-Options、X-Frame-Options、Referrer-Policy。
GPT-5.6-Sol 的版本:一个都没有。
有经验的开发者都知道,安全扫描的第一道检查就是响应头。带安全头是生产级应用的底线,跟刷墙之前先打底漆一样基本。GPT-5.6-Sol 为什么没做?因为它没有"上线之前要过安全扫描"这个概念。它写的代码能跑,但"能跑"和"能上线"之间隔着一整个工程文化。
第二题:登录限流。
GLM-5.3 的版本,第 10 次错误登录请求之后,第 11 次开始返回 429。限流生效了。
GPT-5.6-Sol 的版本:12 次错误全部放行。无限暴力破解。
我给你翻译一下这意味什么:任何拿到 API 端点的人,可以用脚本无限尝试用户名和密码。只要密码库够大,爆破成功只是时间问题。这不是细节,这是安全事故的前奏。
第三题:会话清理。
GLM-5.3 的版本做了会话过期自动清理。启动时清一次,之后每小时清一次。GPT-5.6-Sol 的版本:过期会话永久留存。
三个问题,三个零分。你如果只看"能跑通的核心功能",两个模型打平。但如果你问"这活能不能交付给客户",差距出来了。
还有一个更有趣的观察:UI 风格。
社区已经总结出 AI 生成前端的五个特征:紫蓝渐变、玻璃拟态、发光阴影、hover 弹跳、统一大圆角。GPT-5.6-Sol 的版本几乎全中——暗色玻璃拟态、青蓝紫渐变、发光阴影,一张典型的"AI 风"画皮。
GLM-5.3 的版本逐条规避:亮色扁平工具风、单一靛蓝、1px 描边、零投影。看起来不像 AI 生成的,像一个有设计常识的人类工程师搭出来的工具。
Datawhale 的猜测很有意思:有视觉能力的模型会忠实实现需求描述里的视觉词汇,但描述不等于好设计。没有视觉反馈的模型反而靠代码惯例行事——而代码惯例,恰恰是人类工程师长期试错积攒下来的东西。
代码惯例是工程文化的压缩包。GPT-5.6-Sol 输在它没解压。
最后,GLM-5.3 还自补了两个清单外的功能:历史任务重跑和批量评测。前者让你调完参数一键对比前后效果,后者一键跑 9 张示例图,弹窗出 SAD/MSE/Grad 对照表,可导出 CSV。
这不是模型在炫技。这是它理解"这个任务的目标用户需要什么"——抠图算法的迭代过程中,对比和评测是刚需。GPT-5.6-Sol 没做,因为它只执行清单。
被 50% 和 2404 掩盖的真相
我重申一遍,智谱官方的两个宣传数字——编程能力 +50%,两周发现 2404 个漏洞——是营销弹药,不是工程数据。前者没有给出 GPT-5.6-Sol 同基准对比分数,后者缺乏第三方验证的 CVE 明细。
但 Datawhale 的实测不需要官方宣传。九条验收、三个安全响应头、限流逻辑、会话清理、UI 决策、两个自补功能——这些是公开代码,欢迎你复现。
真正的拐点是:国产开源模型 + 国产 Agent 运行时,第一次拿出了可以直接交付的生产级产出。 这事在 8 月之前不可能发生。
为什么?因为模型不强,Harness 不成熟,两者都缺。GLM-5.2 时代,模型代码写得不错,但工程细节一塌糊涂。DeepSeek Harness 之前,你没有合适的运行时让模型落进生产环境。模型和基础设施必须同时到位,缺一个都跑不出这结果。
这不意味着 GPT-5.6-Sol 要被淘汰了。也不会有人明天就把生产系统全换成国产组合。但你要清楚,"能用国产替代"和"国产更好用"之间,隔着一条叫工程细节的河。GLM-5.3 + DSH 刚刚跨过了这条河。
榜单继续刷,工程拐点才是分水岭
我预测一下:未来三个月,你会看到更多 Coding Agent 的榜单分数被刷新。GPT 出个新版本,GLM 再打回来,谁都不服谁。这种循环跟显卡跑分一样,热闹但没有信息量。
真正值得盯的,是国产模型能不能在更复杂、更长生产链的任务里持续保持工程优势。 抠图 app 是一个切片,一个比较小的切口。ERP 系统、金融交易后端、医疗数据处理,这些场景对工程细节的要求高几个数量级。国产组合能不能在那些地方也压过 GPT,才是下一个真正的考验。
给你一个行动清单,如果你是个认真评估 Coding Agent 的工程师或者技术负责人:
- 别看榜单分数,看同题实测。 要求供应商给出生产级任务的九条验收清单,要求公开代码仓库。
- 重点盯安全响应头、限流、会话管理。 这三样是模型"有没有工程文化"的试金石,因为它们不出现在需求清单里,只出现在工程师的默认习惯里。
- 让模型交付一个超出清单的功能。 它如果只做你要求的事,那是执行。它如果能补上你没说但你需要的,那是交付。
榜单分数会被刷爆,但工程细节不会说谎。 8 月 15 日那天,有人第一次看清了这一点。