FROM THE BOOKSHELF / A PAGE TO KEEP
黄仁勋说别被淘汰的 4 件事,本质是英伟达给自己开的药方
发布于 2026-08-12
黄仁勋说别被淘汰的 4 件事,看完一周内英伟达、Cursor、智谱的连续动作才发现:算力霸权正在被同时拆掉,他的方法论其实是给自己开的药方。
黄仁勋说别被淘汰的 4 件事,本质是英伟达给自己开的药方
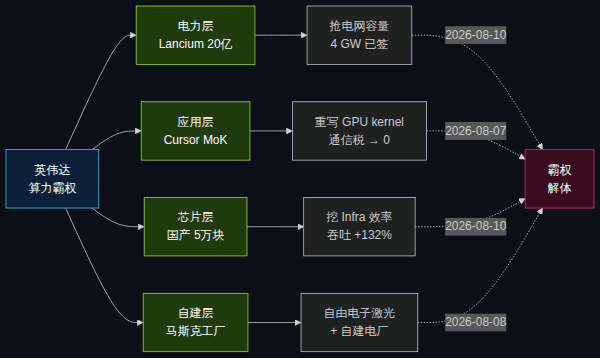
2026 年 8 月 6 日,黄仁勋在 YC Startup School 上讲了一段访谈,被中文媒体整理成"不想被淘汰,马上做 4 件事"。四天后,8 月 10 日,英伟达同意向一家电力公司投 20 亿美元,后续可能再加 10 亿。
同一天,Cursor 开源了 MoK,让 MoE 训练里一次通信延迟从 103μs 降到 18μs——5.7 倍。同一天,《晚点 LatePost》独家披露智谱 API 用户接近 700 万、启用超 5 万块国产算力芯片。
三件事都发生在同一周。这不是巧合,而是同一道题的三个答案。
算力霸权正在被同时拆掉。
<!-- 配图:算力霸权的四面围攻 -->
第一个裂痕:电
卖 GPU 的公司,开始买电。
这笔钱投给的是 Lancium——一家总部在德州的"AI 电力基础设施开发商"。它的本事不是建电厂,而是提前在变电站和输电线路附近"圈地":找到有剩余电力容量的位置,把这块地签下来、给电网公司交接入费,然后等 AI 数据中心客户来用。
Lancium 已经在德州电网锁定并开发 4 GW 电力容量,另外还有 15 GW 的"带电力接入条件的土地"在等审批(来源:The Information,2026-08-10)。其中 1.2 GW 供 Abilene 的 Oracle + OpenAI Stargate 园区用。Crusoe 还在 Childress 建设项目再签 1 GW。
英伟达花 20 亿美元(后续追加 10 亿),拿下 Lancium 约 20% 股权,最终可能持股 30%。对应估值 100 亿美元。
Lancium 不是孤例。截至 2026 年 4 月这一个财季,英伟达向私营企业和基础设施基金投入了 186 亿美元——超过此前一整年。仅这一年里,英伟达就分别向 CoreWeave、Nebius 各投 20 亿,给网络设备公司 Lumentum、Coherent 各 20 亿,给 Marvell 也是 20 亿。
英伟达从"卖铲子"的公司,变成"买铲子"的公司——而且买的不是更多的铲子,是铲子能用的电。
更直接的信号是 8 月 10 日同一天:德州州长 Greg Abbott 下令暂停新的数据中心电网接入申请。算力扩张第一次被电力公司"卡脖子"。英伟达提前三年买电网容量,本质是给自己买一份保险:等同行发现没电可用时,货已经在仓库里了。
第二个裂痕:应用层
黄仁勋说"硬件堆到顶,软件接着改"。Cursor 用 MoK 给这句话交了实操样本。
Cursor 不是芯片公司,是给开发者做 AI 编辑器的创业公司。8 月 7 日,他们开源了一个叫 Mixture-of-Kittens(MoK)的内核。它干的事情非常简单——把 MoE 训练里的 token 调度、跨 GPU 通信、专家计算三件原本串行的事,塞进同一个 GPU kernel 里。
5.7 倍加速。
这件事为什么重要?因为它揭穿了一个尴尬的事实:NVIDIA GB300 NVL72 整机架 NVLink 峰值带宽达到 130 TB/s,按这个规格看,GPU 之间传数据已经足够快了。可在大规模 MoE 训练里,通信依然拖住专家计算。
原因藏在 MoE 的工作流里:Router 每一步都重新决定 token 去哪个专家,专家分散在不同 GPU 上。一个"通信"阶段里其实混着数据搬运、布局生成、同步和负载失衡几件事,130 TB/s 是峰值带宽,不是每次动态零碎的 MoE 通信都能把这些链路同时跑满。
传统做法用多 CUDA Stream 让通信和计算并发,却很难保证两边都拿到恰到好处的 GPU 资源。MoK 的设计是直接让通信和计算同时占用 GPU 的 SM 单元,不再分开排队。
<!-- 配图:MoE 通信税 vs MoK 的同 kernel 解法 -->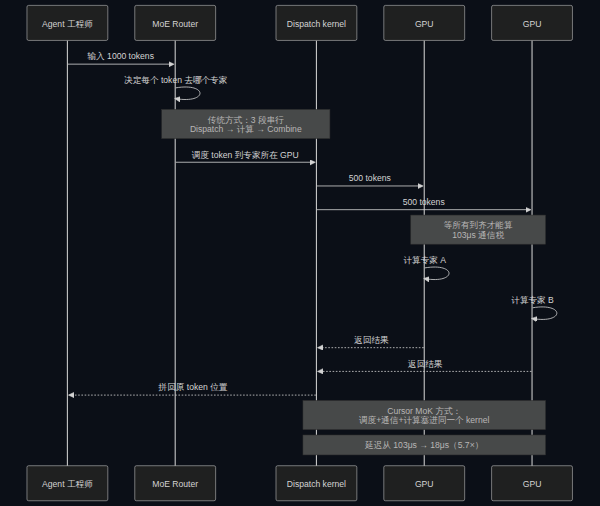
硅星人那篇报道里有一句很到位的话:"硬件跑得再快,也救不了低效的软件编排。"
这句话是 Cursor 的宣言,也是给英伟达的备忘录:当客户开始重写你的 GPU 怎么用,你就不再是唯一的算力定义者。
第三个裂痕:地理
美国公司有钱就买电,中国公司没钱就改算法。
晚点独家披露的智谱数据:2026 年 8 月,API 用户接近 700 万,比 7 月初多了 200 万;ARR 增长 15 倍;启用超 5 万块国产芯片(来源:晚点 LatePost,2026-08-10)。在物理硬件没办法快速扩展的情况下,智谱选择挖 Infra 效率。
具体怎么做?两个案例。
第一个:和"中科加禾"(一家国产推理芯片公司)联合研发的分拆 KVCache 方案。一个 Agent 干活时平均要往模型里塞 7 万多 token 的上下文,远超日常聊天内容,KVCache 不能整块塞进显存。智谱的拆分方案把单个推理服务吞吐随长程任务增长而最高提升 132%。
第二个:名为 ZCube 的大模型推理网络架构方案,提升整个生产集群吞吐量高达 15%,同时降低 AI 基建中交换机和光模块需求多达三分之一。
特斯拉和 SpaceX 走第三条路。马斯克 8 月 8 日官宣"全球最大芯片厂",用自由电子激光做光刻,还要自建发电厂。这是把"算力霸权"拆成垂直整合:芯片、电力、激光器全部自造。
同一个算力短缺问题,分叉出三种应对法。
<!-- 配图:四类应对法 quadrant -->
黄仁勋那 4 件事真正在回答谁
回到开头那篇被中文媒体刷屏的访谈笔记。
黄仁勋讲的不是鸡汤,他讲的是 1995 年的英伟达自己:选错了第一套 3D 图形算法,全公司没人知道正确答案,他口袋里只有几百美元,跑去电子商店买了三本 OpenGL 教材,从头学。
四件事看起来都很日常:
-
发现自己错了,马上转向。具体方案该改就改,长期要解决的问题依然坚持。1995 年改算法,今天改的是"GPU 够不够"的判断。
-
遇到不懂的,尽快学会。AI 让获得知识变得容易,但学习新知识的速度、把它用到真实问题里的能力,会越来越重要。
-
靠近一线,亲自把问题弄明白。组织越大,创始人越容易离真实问题远。信息经过层层汇报,细节被删掉,风险被忽视。
-
先开始,再把困难一点点解决。"这能有多难?"这句话的作用是让人先动起来。
这 4 件事,原话是在 YC Startup School 上对创业者说的。但你把它放在英伟达 2026 年这一周的三个动作旁边看,会发现它更像是给 CEO 群体开的方子。
投电网,就是"发现自己错了马上转向"——继续堆 GPU 边际收益递减,转头去买电厂。
学电力调度和 Token 经济学,就是"遇到不懂尽快学"——黄仁勋这个级别的创始人 30 年没碰过的领域。
把投资团队下到 Lancium 的变电站谈判桌,就是"靠近一线"。
砸 20 亿美元先签 4 GW 电力容量,就是"先开始再解决"。
黄仁勋给你的不是鸡汤,是英伟达自己的止损纪律。 他经历过一次这样的关键时刻——1995 年那次,他带着全公司从错路上拉回来。这次他赌的是:AI 算力的瓶颈已经不在 GPU 里,所以英伟达不能再赌 GPU。
你这周做了什么"承认走不通"的事?
把三件事串起来看,结论其实很清楚:
算力霸权的解构,正在同时发生。 电力、应用层、地理三面夹击下,单一公司的"GPU 单边押注"已经不是好策略——它甚至连"够用"都难保证。
未来 12 个月,能活下去的不是 GPU 最多的公司,而是最先承认"GPU 不够用"的公司。
承认走不通不需要可耻。可耻的是 GPU 已经堆到顶,还在假装电是配套的。
你这周做了什么承认"这条路走不通"的事?
如果答案是"没有",问题不在你——问题在你还没开始看 GPU 之外的世界。