删掉80%的Skill,Agent反而更强了——2026年,别再往Prompt里塞规则了
发布于 2026-07-30
Claude Code砍80%系统提示词评测反升;腾讯云开发者1500行Skill砍到300行后遵循率明显回升。2026年Agent工程的核心红利不在加法,而在减法。
删掉80%的Skill,Agent反而更强了——2026年,别再往Prompt里塞规则了
2026年7月,数字生命卡兹克记了一笔账。
他让一个Agent跑了个长程任务,目标定义得模糊了点。Agent没偷懒,它认认真真跑了整整一夜。等他早上打开电脑,20亿Token烧没了,Agent在错误的方向上一路狂奔了8小时。Agent越勤奋,浪费越彻底——而罪魁祸首不光是目标模糊,更大的坑是规则写得太多太满。
<!-- 配图:膨胀的Skill文件示意,红线圈出重复段落 -->2026年的Agent开发者陷入了一个集体幻觉:只要把规则写够细、禁令叠够多,Agent就会听话。
现实反手就是一巴掌。
1500行的Skill,每条规则重复8遍
腾讯云开发者郑姝雅维护着一个数据质量检测Agent的Skill。上线之后,模型开始"犯病":挑错工具、输出被禁字段、"四个维度必须覆盖"的规则下,某个维度因为常年正常就被悄悄跳过了。
她的对策很工程师——接了个自动修复工具。每次Badcase喂进去,工具自动分析、生成修复规则、更新文档、发布。她只看修复结果,不审文档。效率很高。
40次迭代后,她终于打开文档从头读了一遍。
Skill从400行膨胀到了1500行。同一条规则被塞进了8个不同位置,以一种完全不同的措辞。"严禁"、"铁律"层层加码——同一句话通过排列组合繁衍出一个家族。而模型犯错的频率,反而更高了。
越强调,文档越长;越长,注意力越分散;越分散,违反越多;违反越多,再追加一遍。
她把1500行砍到300行,按分层架构重写后,核心规则的遵循率明显回升。不是AI不听话,是它被噪声淹没了。
Anthropic也发现了——删80%,评测不降
如果你觉得这只是个例,看看Anthropic。
团队成员Thariq Shihipar透露,他们把Claude Code的系统提示词砍了超过80%,内部编程评测没有任何下滑。Qoder工程师陈成抓取了实际请求做对比:Opus 4.7时系统提示词15225字符,到Opus 4.8直接砍到4467字符,降了71%。
注意一个细节:砍完之后,团队又加了点东西回去——Opus 5回升到7694字符。加的是什么?"Delivering work + Corrections"——专门用来治新模型的"坏脾气"。核心动作只有一个:只写不得不写的那部分,其余全扔。
扔掉的六类内容是:让模型自判断、少给示例改设计接口、按需加载不一次性加载、说一次就好、交给自动记忆、只给简单规格。
每一条的潜台词都是同一件事:别把模型当白痴,也别把自己当保姆。
这跟代码工程是一个道理——你见过哪个优秀的代码库是堆try-catch堆出来的?每个错误都加一个catch,catch套catch套catch,最后没人能读懂执行流。
注意力是物理定律,不是鸡汤
为什么加规则反而更差?
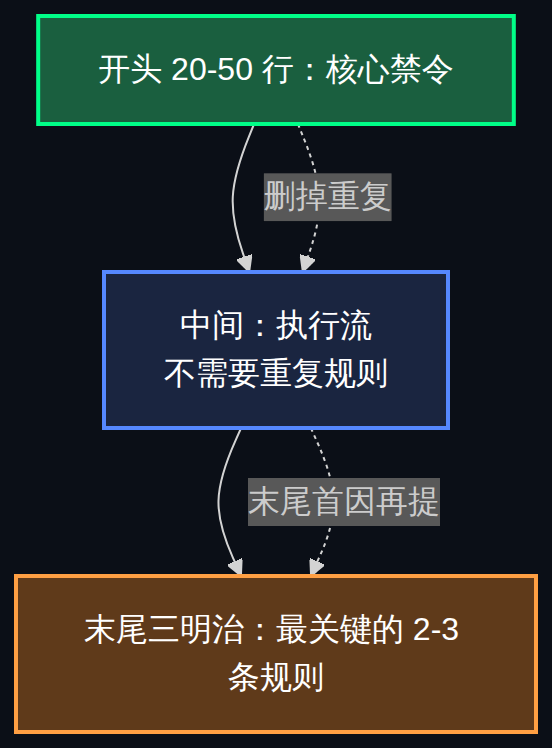
Stanford那篇经典论文"Lost in the Middle"把话说得很清楚:LLM的注意力分布是U形的。开头和末尾最强,中间掉30%到50%。你往Skill里塞1500行,关键规则在前面没动——问题是后面多了1400行"中间内容",注意力被稀释得干干净净。
这跟"强调"是两个完全不同的概念。你重复5遍,注意力不会增强5倍——它只会把其他规则的注意力配额抢走。
另一个更坑的问题是隐性冲突。研究显示,顶级模型在指令冲突场景下,23%到47%的情况会出问题。郑姝雅的Skill里有个经典bug:
- 规则A:"分析必须覆盖四个质量维度"
- 规则B:"正常维度不展开"
当某个维度稳定在99.9%时,模型静默选择B,丢掉A——因为B给了它一个"合理的"跳过理由。模型不会报错,它只是用你的逻辑打败了你的逻辑。
还有否定指令。多项研究证实,"不要做X"的遵循率远低于"只做Y"。token生成是正向选择——你越说"别想粉红大象",模型越要先把"粉红大象"这个token激活一遍。这不叫听话,这叫条件反射失败。
<!-- 配图:注意力U形曲线示意图 --> <!-- 配图:三明治法则示意图,首尾高亮 -->