万亿参数是行业走过的弯路——唐杰和 GLM-5.3 给出的反 Scaling 答案
发布于 2026-08-20
智谱唐杰公开反 Scaling——万亿参数是行业走过的弯路。GLM-5.3 用同架构同参数、一个月后训练拿到非小幅提升。Qwen 3.8 27B、Gemini 3.7 Flash、Libra 三家分头出发,指向同一个判断:后训练才是下一个三年的入场券。
万亿参数是行业走过的弯路——唐杰和 GLM-5.3 给出的反 Scaling 答案
2026 年 8 月 19 日下午,智谱联合创始人、首席科学家唐杰在 X 平台发了一篇长文。他只表达了一个核心判断:万亿参数模型,是行业走过、随后又共同折返的一段弯路。(来源:智东西 2026-08-19 编译自唐杰 X 发文)
不是 Scaling 死了,是「只追参数」这条单一路径死了。
两次集体折返
行业为「参数傲慢」付过两次账单。
2020 年 Kaplan 团队的研究拟合出一条扩展规律:参数增长速度应该快于数据增长速度,两者的扩展指数约为 0.73 比 0.27(来源:Kaplan 等 2020 论文,唐杰 X 发文引用)。这条曲线让 GPT-3、Gopher、MT-NLG 全部跟着跑。那一刻,「万亿参数」被默认成了衡量前沿模型的标准动作。
两年后 Hoffmann 团队重新做实验,把约 400 个模型跑了一遍。结论是:在拥有充足算力的情况下,每个参数对应 20 个 Token 是计算最优的配置。参数量和数据量应该接近同步增长,而不是继续拉开距离(来源:Hoffmann 等 2022 Chinchilla 论文,唐杰 X 发文引用)。
唐杰在 X 里直接挑明:「早期拟合中的误差,会随着计算量每提高一个数量级而继续放大。因此,那一代规模最大的模型,也成为计算资源分配最不合理的模型。」
行业为「参数傲慢」付了两次账单,第一次叫 2020,第二次叫 2022。 两次都以为自己找到了 Scaling 的终点,结果两次都走到了下一段才发现调错了钮。
MoE 把「参数量」撕成两张皮
更麻烦的是:MoE 出现之后,「参数量」这个指标已经不是一个数。
总参数量大致决定模型能装多少知识——事实、长尾事实、跨领域常识。激活参数量加上有效计算深度,决定模型能跑多深的推理链,能不能在不崩溃的情况下完成 20 步因果推演(来源:唐杰 X 发文)。
Roberts 等人在 2025 年的研究把这件事讲清楚:最优的 Token-参数比和任务类型挂钩。记忆类任务更受益于加参数,推理类任务更受益于加数据。 后续针对 MoE 的研究更进一步——在 Token-参数比不变的情况下继续加总参数量,反而可能削弱推理能力;增加每次激活的专家数量,才能持续稳定地改善推理表现(来源:唐杰 X 发文引用)。
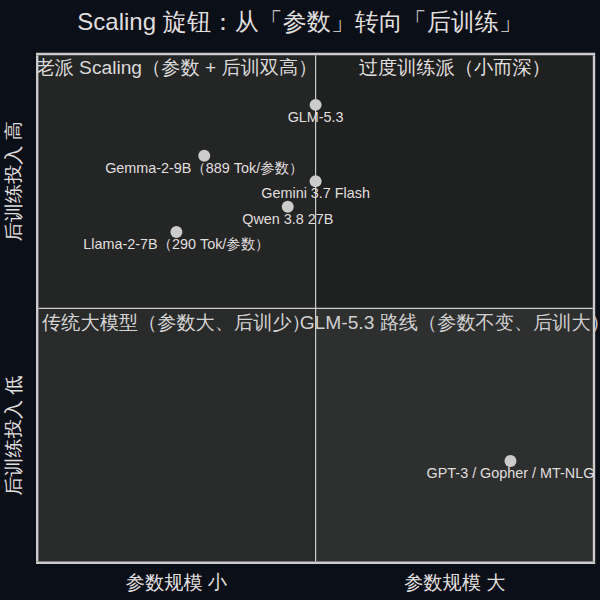
这就是 Llama-2-7B 和 Gemma-2-9B 走「过度训练」路线的原因——Llama-2-7B 平均每个参数对应约 290 个训练 Token,Gemma-2-9B 把这个数字推到 889(来源:唐杰 X 发文)。它们不靠堆参数,靠把每一个参数「榨干」。
唐杰把这个判断用 GLM-5.3 做了一次对照实验:基础模型、架构、总参数量、激活参数量全部与 GLM-5.2 相同,唯一变量是「长程任务环境 + 强化学习后训练」,花了整整一个月。取得的提升,唐杰原话是「并非小幅改进」。
一个值得停下来想的事实:GLM-5.3 没有增加任何「模型容量」,却换来了「非小幅」的推理能力提升。这意味着过去 12 个月,团队把时间花在「让模型把已有能力打透」,而不是「让模型容量再翻一倍」。这一选择本身就是对「只追参数」路径的公开反水。
GLM-5.3 的方向也呼应了 2025 年 Roberts 等人对「任务类型决定 Token-参数比」的判断——既然推理类任务更依赖训练数据与后训练,那把团队精力往这两个方向集中,比单纯推参数规模更划算。智谱用一次实际的版本发布,把这个学术结论变成了工程现实。

Scaling 像调音台上的多个推子。过去三年,行业只推「参数」这一根。现在轮到「后训练」。