万亿参数走过的弯路,唐杰给中国大模型算了一笔新账
发布于 2026-08-20
8/19 智谱唐杰在 X 发长文,把万亿参数模型定义为行业集体走过的弯路;同期 GLM-5.3 上线,不动基座只扩后训练,AA 指数 53 拉到 60。本文拆解 Scaling Law 的三段修正、MoE 把'参数'拆成两件事、以及为什么智谱选择把算力押在'调教'上。
万亿参数走过的弯路,唐杰给中国大模型算了一笔新账
8 月 19 日下午,智谱联合创始人唐杰在 X 上发了一篇两千字长文。核心就一句话:万亿参数,是整个行业一起走过、又一起折返的弯路。
同一天,GLM-5.3 正式上线。基座完全没动——总参数还是 753B、激活参数还是 40B——但 AA 指数从上一代的 53 拉到了 60,编程能力提升 50%,两周内发现 2404 个安全漏洞(《GLM-5.3 来了》8/15 报道)。
这件事不只是智谱的内部选择。它是中国头部大模型公司第一次明确说出:"参数量,不再是 Scaling Law 的关键旋钮。"
行业的病:只拧低音旋钮的五年
2020 年,Kaplan 等人拟合出一条规律:参数的增长速度应该比数据快得多,对应指数大约 0.73 和 0.27(据唐杰 8/19 长文转述,智东西编译)。GPT-3、Gopher、MT-NLG 全部按这个比例往大了做。
三年后 Hoffmann 等人拿 400 多个模型重新算了一遍,发现算力最优的分配更接近每个参数 20 个 Token。参数量和数据量应当以接近的速度一起增长,而不是不断拉开差距。
回过头看,那一代最大的模型,恰好是算力分配最失衡的一批。早期拟合里的误差,会在计算量每提高一个数量级时被进一步放大——这一判断来自 Hoffmann 团队在 2022 年的工作,也是唐杰这次明确表态的起点。
唐杰给出了一个形象的比喻:Scaling Law 像调音响的低音旋钮。 行业连续五年只拧"参数量"这一个旋钮,结果把别的旋钮都拧没了。低音再大,也不会变成 HiFi。
但 Chinchilla 也不是终点。它的优化目标是"训练一次、评测一次"。今天的模型上线以后,每天可能被调用几十亿次,推理成本早就盖过了那一次训练。
把推理成本也算进账本里,最优方案开始向"规模更小、训练时间更长"的模型移动。这是一种有意进行的"过度训练"——Llama-2-7B 平均每个参数对应约 290 个 Token,Gemma-2-9B 对应约 889 个 Token(数据据唐杰 8/19 长文转述)。两款模型都比 Chinchilla 推荐的 20 Token/参数高出一个数量级。
当一件商品每天被用几十亿次,"出厂配置"就不再是最贵的成本。 真正的成本是它在用户手上那 1 秒里烧掉的算力。

MoE 时代,"参数量"这个词已经失效
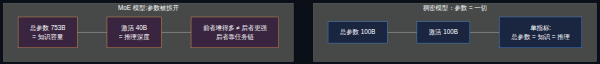
到 MoE(混合专家模型)这里,"参数"这个指标干脆被拆成了两件完全不同的事。
唐杰这次把这件事讲得很清楚:
- 总参数量,大致决定模型能装下多少知识、事实和长尾信息。
- 激活参数量 + 每次前向计算的有效深度,大致决定模型能做多深的思考、能维持多少步因果推理而不崩。
这两个指标在稠密模型里是同一个数,所以早期没人意识到它们是分开的。到了 MoE,总参数可能是激活参数的十倍甚至几十倍,继续把它们当成一回事就会得出错误的结论。
唐杰给了一个具体的反例:寻找一项安全漏洞不是信息检索。它并不取决于模型记住了多少 CVE 漏洞记录,而在于模型能否完成一条包含 20 个步骤的推理链,并在到达终点前始终保持思路连贯。这种能力并不存在于总参数量本身。
后续针对 MoE 的研究还发现一件更反直觉的事:在 Token/参数比不变的情况下,继续放大总参数量反而可能削弱推理能力;增加每次激活的专家数量,则能更稳定地改善推理表现。
这意味着"模型规模"这个概念本身需要被重新定义。
家里有一万本书,不代表你能写出一篇论文。 书架上摆着多少书,对应的是知识容量;今天你翻开过哪几本、走过多深的推理链,对应的才是产出能力。MoE 把这两个数从同一个数字里拆开了。